目录 ▾
Building Effective Agents|构建有效的智能体 【翻译+总结】
更新说明: 本文所描述的许多工具生态,自 2024 年 12 月以来已经发生变化。关于 Anthropic 当前采用的方法,请参阅 How we built Claude Managed Agents 以及 Managed Agents documentation。
过去一年里,我们与来自不同行业的数十个团队合作,共同构建大型语言模型(LLM)智能体。
我们反复观察到一个现象:
最成功的实现,并没有使用复杂的框架(Framework)或专门的库(Specialized Libraries)。相反,它们往往建立在简单、可组合(Composable)的模式之上。
在本文中,我们将分享与客户合作以及亲自构建 Agent 过程中获得的经验,并为开发者提供一些关于如何构建有效 Agent 的实用建议。
一、什么是 Agent?
“Agent”可以有很多种定义。
一些客户将 Agent 定义为一种完全自主的系统:它可以在较长时间内独立运行,并使用各种工具完成复杂任务。
另一些客户则使用 Agent 这个词来描述更加规定式(Prescriptive)的实现,也就是按照预先定义好的工作流执行任务。
在 Anthropic,我们将这些不同形式统称为:
Agentic Systems(智能体系统)
但在架构层面,我们会特别区分两类系统。
Workflows
Workflows 是通过预先定义好的代码路径(Predefined Code Paths)来编排 LLM 和工具的系统。
Agents
Agents 则是由 LLM 动态决定自己的执行过程以及工具使用方式的系统。
也就是说,LLM 自己掌握“如何完成任务”的控制权。
译者注:
这是全文最重要的定义之一。
Workflow 和 Agent 的核心区别并不是“简单 vs 复杂”,而是:谁拥有执行路径的控制权?
Workflow

程序决定下一步
    ↓
调用 LLM / Tool
    ↓
程序继续决定下一步
Agent
LLM 判断当前状态
↓
决定下一步 Action
↓
调用 Tool
↓
获得 Environment Feedback
↓
LLM 再次决定二、什么时候应该使用 Agent?什么时候不应该?
在构建 LLM 应用时,我们建议:
尽可能寻找最简单的解决方案,只在确实有必要的时候增加复杂度。
这甚至可能意味着完全不构建 Agentic System。
Agentic Systems 通常是在用:
更高 Latency
+
更高 Cost
        ↓
换取
        ↓
更好的 Task Performance
因此,需要认真判断这种权衡什么时候才真正值得。
当确实需要增加复杂度时:
Workflow 更适合定义明确的任务,因为它能够提供更好的:
- Predictability(可预测性)
- Consistency(一致性)
而当任务需要:
- Flexibility(灵活性)
- Model-driven Decision-making(模型驱动决策)
并且需要规模化运行时,Agent 往往更加合适。
但对于很多应用来说:
优化一次 LLM 调用,再结合 Retrieval 和 In-context Examples,通常已经足够。
译者注:
Anthropic 隐含给出了一个非常重要的复杂度阶梯:
Single LLM Call
        ↓
LLM + Retrieval / Tools
        ↓
Workflow
        ↓
Agent
原则是:
上一层能解决问题
        ↓
不要进入下一层
三、什么时候以及如何使用 Framework?
目前已经有很多 Framework 可以帮助开发者更加容易地实现 Agentic Systems,例如:
- Claude Agent SDK
- AWS Strands Agents SDK
- Rivet
- Vellum
这些 Framework 可以简化很多标准的底层工作,例如:
- 调用 LLM
- 定义 Tools
- 解析 Tool Calls
- 将多个 LLM Call 串联起来
因此,它们能够帮助开发者快速开始。
但是 Framework 往往也会引入额外的抽象层(Abstraction Layers)。
你的代码
   ↓
Framework
   ↓
Prompt 构造
   ↓
LLM API
   ↓
Tool Call
   ↓
Framework Runtime
抽象层越多,你越可能看不到:
模型到底收到了什么?
模型到底返回了什么?
Tool Call 到底如何产生?
History 如何被拼接?
失败是在哪一层发生的?
这会让 Debugging 变得更加困难。
Framework 还可能诱使开发者加入原本并不需要的复杂度,而一个更加简单的实现可能已经足够。
因此,我们建议开发者:
一开始直接使用 LLM API。
很多常见 Agent Pattern 实际上只需要几行代码就能够实现。
如果确实使用 Framework,也应该确保:
你理解 Framework 底层到底在做什么。
四、Building Blocks、Workflows 与 Agents
接下来,我们会介绍在生产环境中经常看到的一些 Agentic System Pattern。
整体复杂度是逐步增加的:
Augmented LLM
      ↓
Prompt Chaining
      ↓
Routing
      ↓
Parallelization
      ↓
Orchestrator-Workers
      ↓
Evaluator-Optimizer
      ↓
Autonomous Agent
这里并不是说后面的模式一定“更高级”。
而是:
控制逻辑更动态
+
系统复杂度更高
+
模型拥有更多决策空间
五、Building Block:Augmented LLM
Agentic System 最基本的构建模块,是一个经过增强的 LLM。
也就是:
Augmented LLM(增强型 LLM)
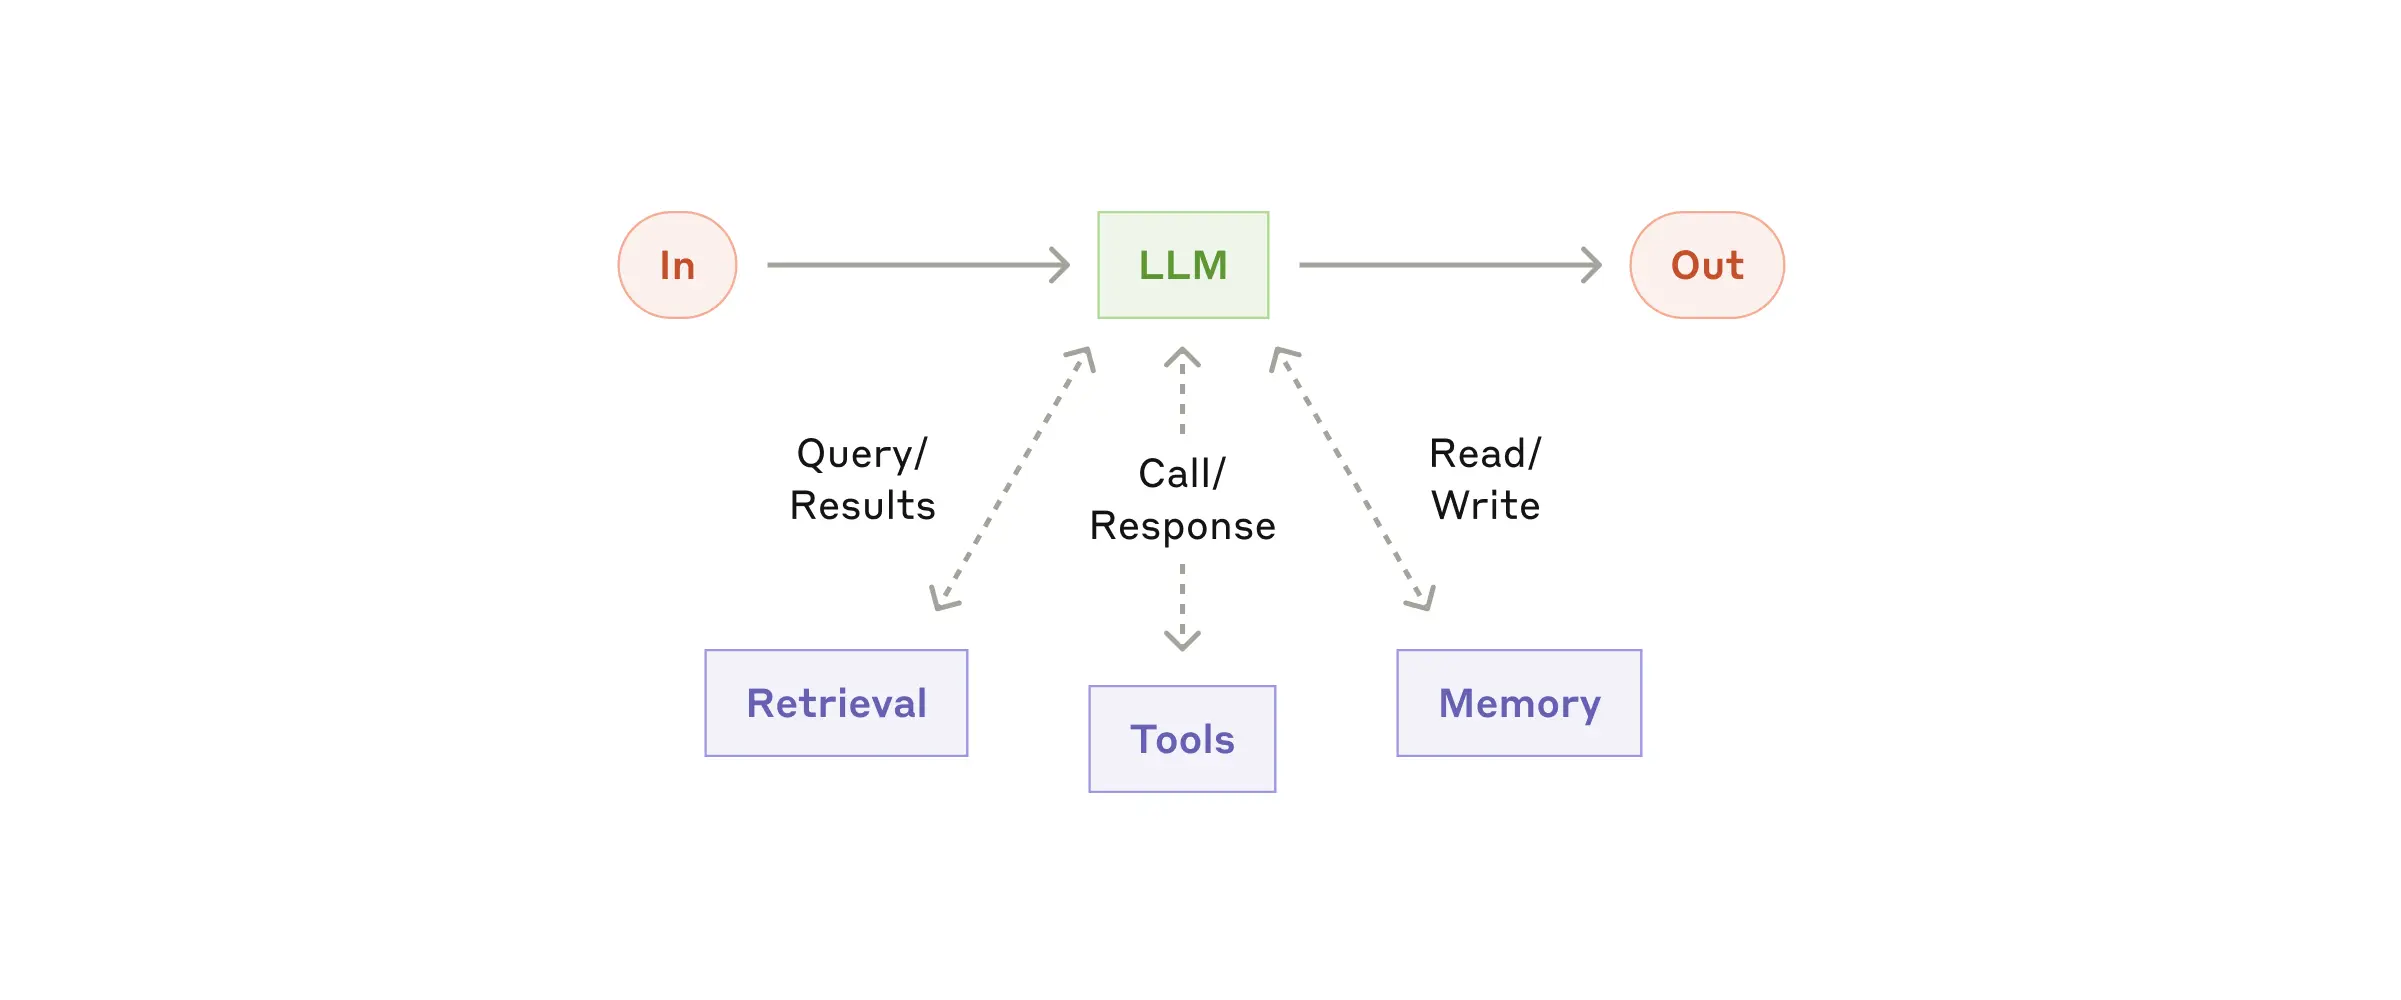
典型结构:
             ┌──────── Retrieval
             │
User → LLM ──┼──────── Tools
             │
             └──────── Memory
可以简单理解为:
LLM
+
Retrieval
+
Tools
+
Memory
=
Augmented LLM
现在的模型已经能够主动使用这些能力,例如:
自己生成 Search Query
        ↓
选择合适的 Tool
        ↓
获取外部信息
        ↓
判断哪些信息应该保留
在实现这些能力时,我们建议重点关注两个问题。
第一:针对具体 Use Case 定制能力
不要只是因为某个能力存在就接入。
需要根据实际业务场景设计:
Retrieval
Tool
Memory
Context
第二:为 LLM 提供简单且文档清晰的接口
LLM 是否能够可靠地使用这些能力,很大程度上取决于接口本身是否容易理解。
译者注:
可以把 Augmented LLM 看成整个 Agent 系统的“原子能力”。
后面的 Workflow 和 Agent,本质上是在解决:
这些能力怎么组织?
        +
什么时候调用?
        +
由谁决定调用?
六、Workflow:Prompt Chaining
**Prompt Chaining(提示链)**将一个任务拆解成一系列连续步骤。
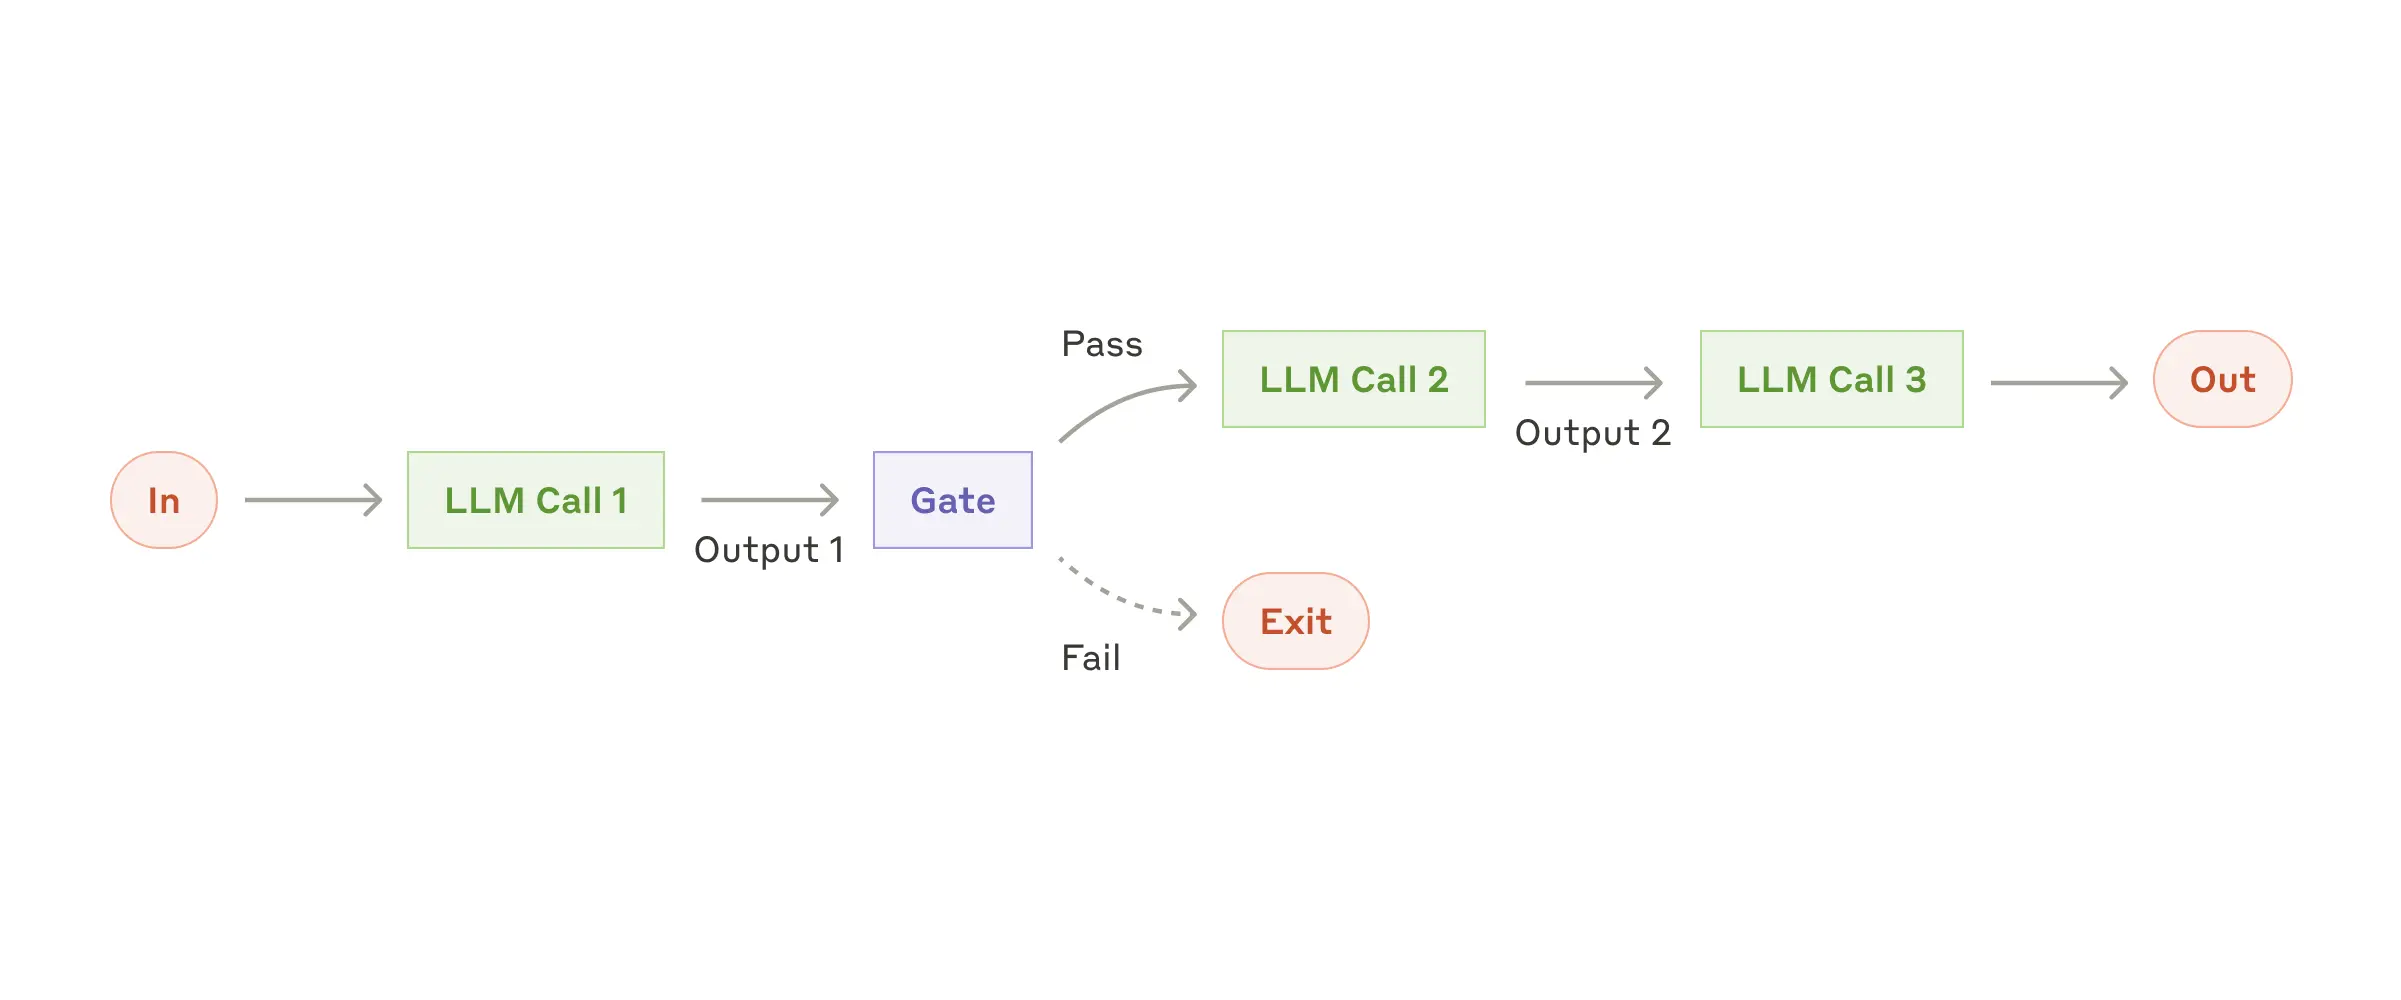
每一次 LLM Call 都处理上一次 LLM Call 的输出。
Task
 ↓
LLM 1
 ↓
Output 1
 ↓
LLM 2
 ↓
Output 2
 ↓
LLM 3
 ↓
Final Result
还可以在中间加入程序化检查:
LLM 1
  ↓
Output
  ↓
 Gate
 /   \
通过   不通过
 ↓      ↓
LLM 2  Retry / Reject / Human
什么时候适合 Prompt Chaining?
当任务可以非常容易、清晰地拆解成固定子任务时,这种 Workflow 非常合适。
核心权衡是:
更多 LLM Calls
      ↓
更高 Latency
      ↓
每一步任务更简单
      ↓
整体 Accuracy 可能更高
示例
生成营销文案
    ↓
翻译成目标语言
或者:
生成 Outline
    ↓
检查 Outline
    ↓
满足要求?
  /      \
否        是
↓         ↓
修改      撰写全文
译者注:
Prompt Chaining 真正重要的不只是“串起来”,而是:
中间步骤可以加入确定性的 Gate。
七、Workflow:Routing
**Routing(路由)**首先对输入进行分类,然后把输入发送到专门的后续任务。
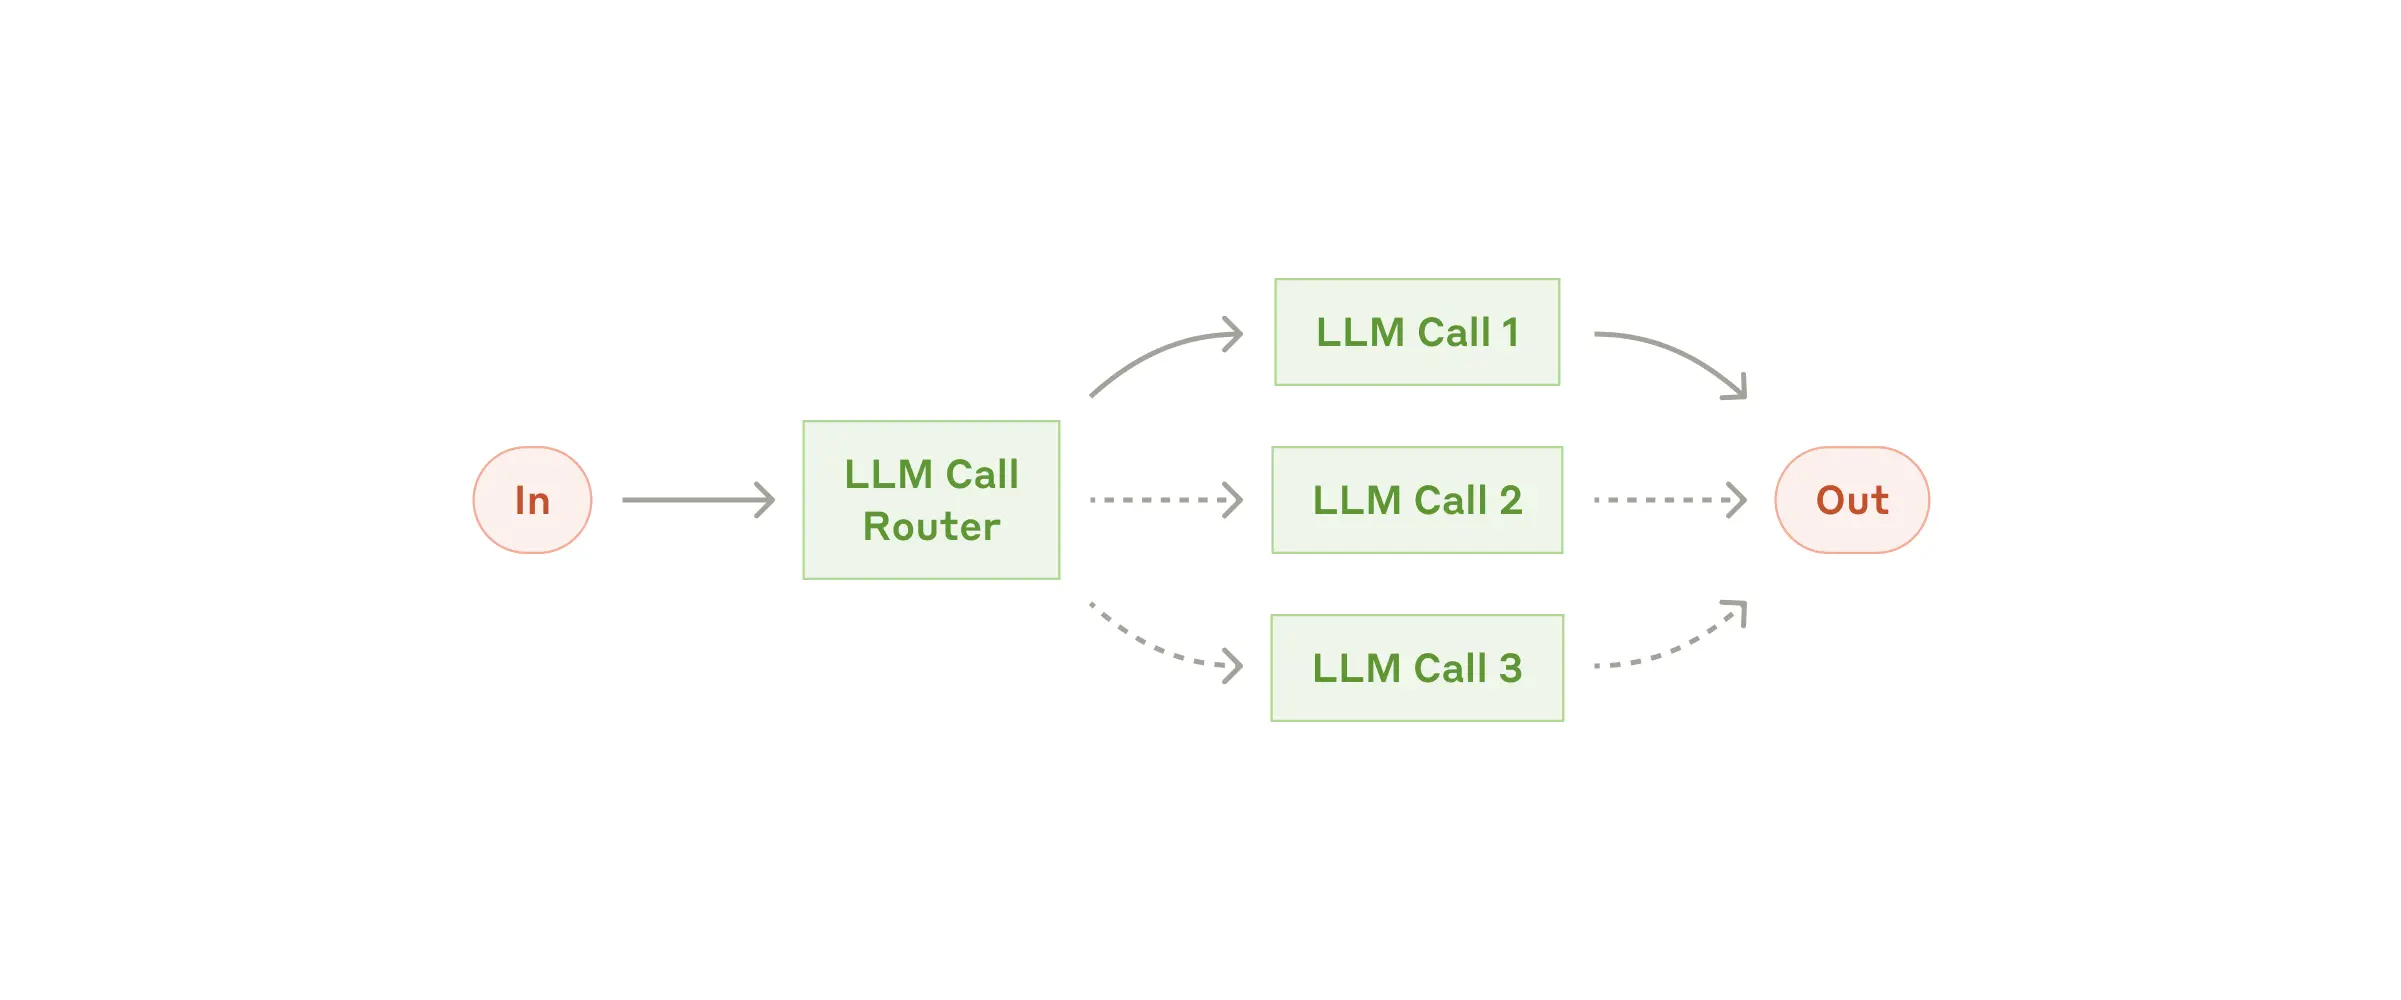
                ┌→ General QA Workflow
                │
Input → Router ─┼→ Refund Workflow
                │
                └→ Technical Support Workflow
这样可以实现:
Separation of Concerns(关注点分离)
不同类型的问题可以使用不同的:
Prompt
Model
Tool
Workflow
Policy
什么时候适合 Routing?
当一个复杂任务存在明显不同的类别,并且不同类别最好分别处理时,Routing 非常有效。
前提是:
Classification 能够比较准确地完成。
分类可以由:
Rules
Traditional Classifier
LLM
完成。
模型 Routing 示例
User Question
     ↓
   Router
   /    \
简单     复杂
 ↓        ↓
Haiku   Sonnet
这样可以在:
Cost
Performance
Latency
之间进行权衡。
译者注:
Routing 并不等于 LLM Routing。
更合理的生产结构往往是:
Input
  ↓
Rules 能确定?
 /          \
是           否
↓            ↓
Rule Route   LLM Routing
                ↓
            仍不确定?
             /     \
            否      是
            ↓       ↓
        Workflow  Unknown/Human
LLM Routing 真正擅长的通常是:
模糊输入
+
非结构化信息
+
多信号综合
+
规则难以穷举的长尾情况
八、Workflow:Parallelization
有些任务可以让多个 LLM 同时执行,然后通过程序聚合结果。
这种 Workflow 称为:
Parallelization(并行化)
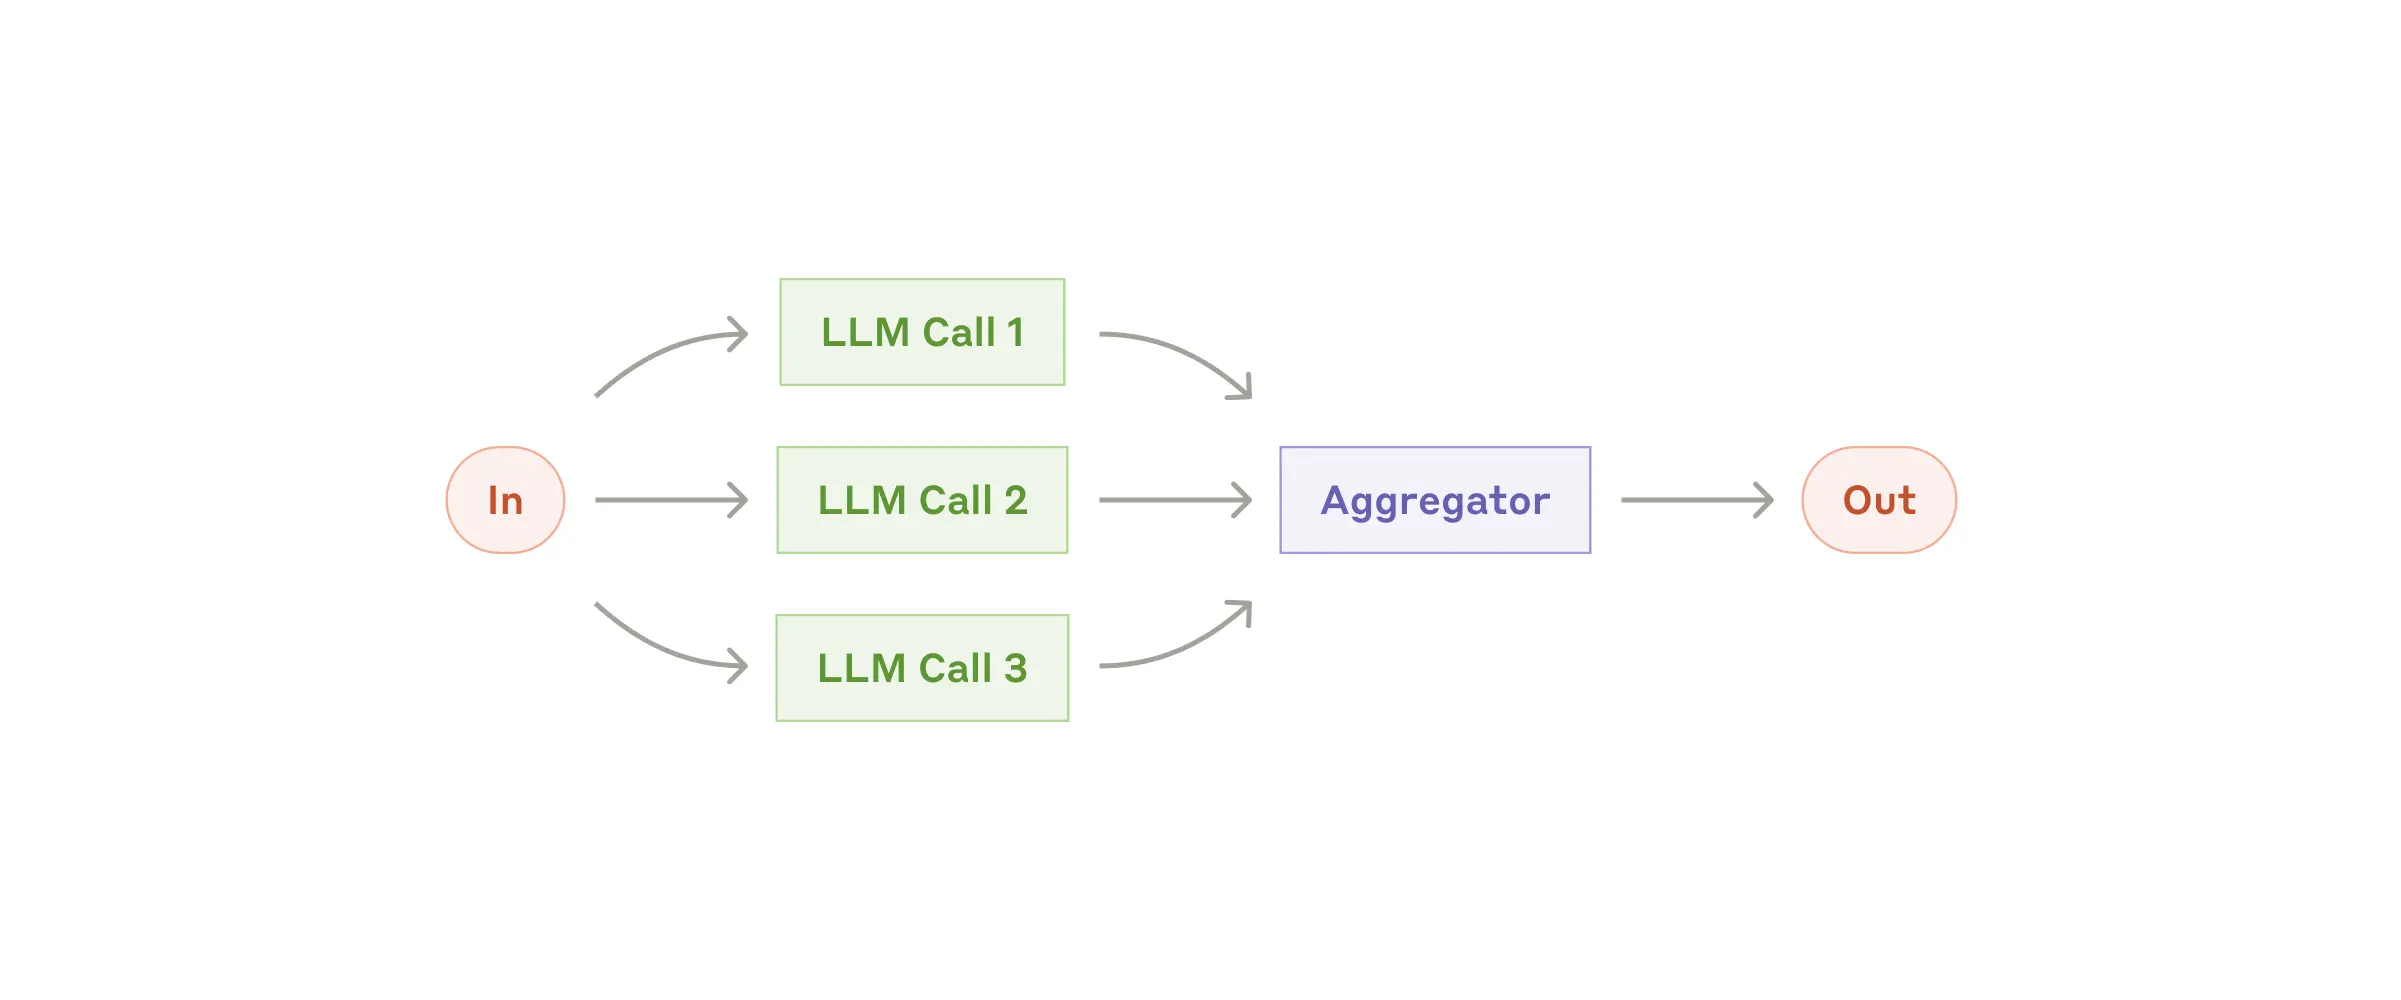
主要有两种形式。
1. Sectioning
将任务拆成多个相互独立的子任务,并行执行。
                  ┌→ Worker A:安全检查
                  │
Task → Fan-out ───┼→ Worker B:事实检查
                  │
                  ├→ Worker C:格式检查
                  │
                  └→ Worker D:质量检查
                          ↓
                       Fan-in
                          ↓
                     Final Result
2. Voting
让多个 LLM 执行相同任务,再聚合结果。
                 ┌→ LLM 1 → Result A
                 │
Same Task ───────┼→ LLM 2 → Result B
                 │
                 └→ LLM 3 → Result C
                           ↓
                          Vote
                           ↓
                      Final Decision
什么时候适合 Parallelization?
主要有两个目标:
目标 1:Speed
独立任务并行执行

目标 2:Confidence
多个 Perspective / Attempt
译者注:
对后端开发而言,可以直接类比:
fan-out
   ↓
workers
   ↓
fan-in
真正困难的通常不是并发本身,而是:
Timeout
Partial Failure
Retry
Result Conflict
Aggregation
Cancellation
Overall Budget
九、Workflow:Orchestrator-Workers
在 Orchestrator-Workers Workflow 中:
一个中央 LLM 动态拆解任务;
然后把子任务分配给 Worker;
最后综合结果。
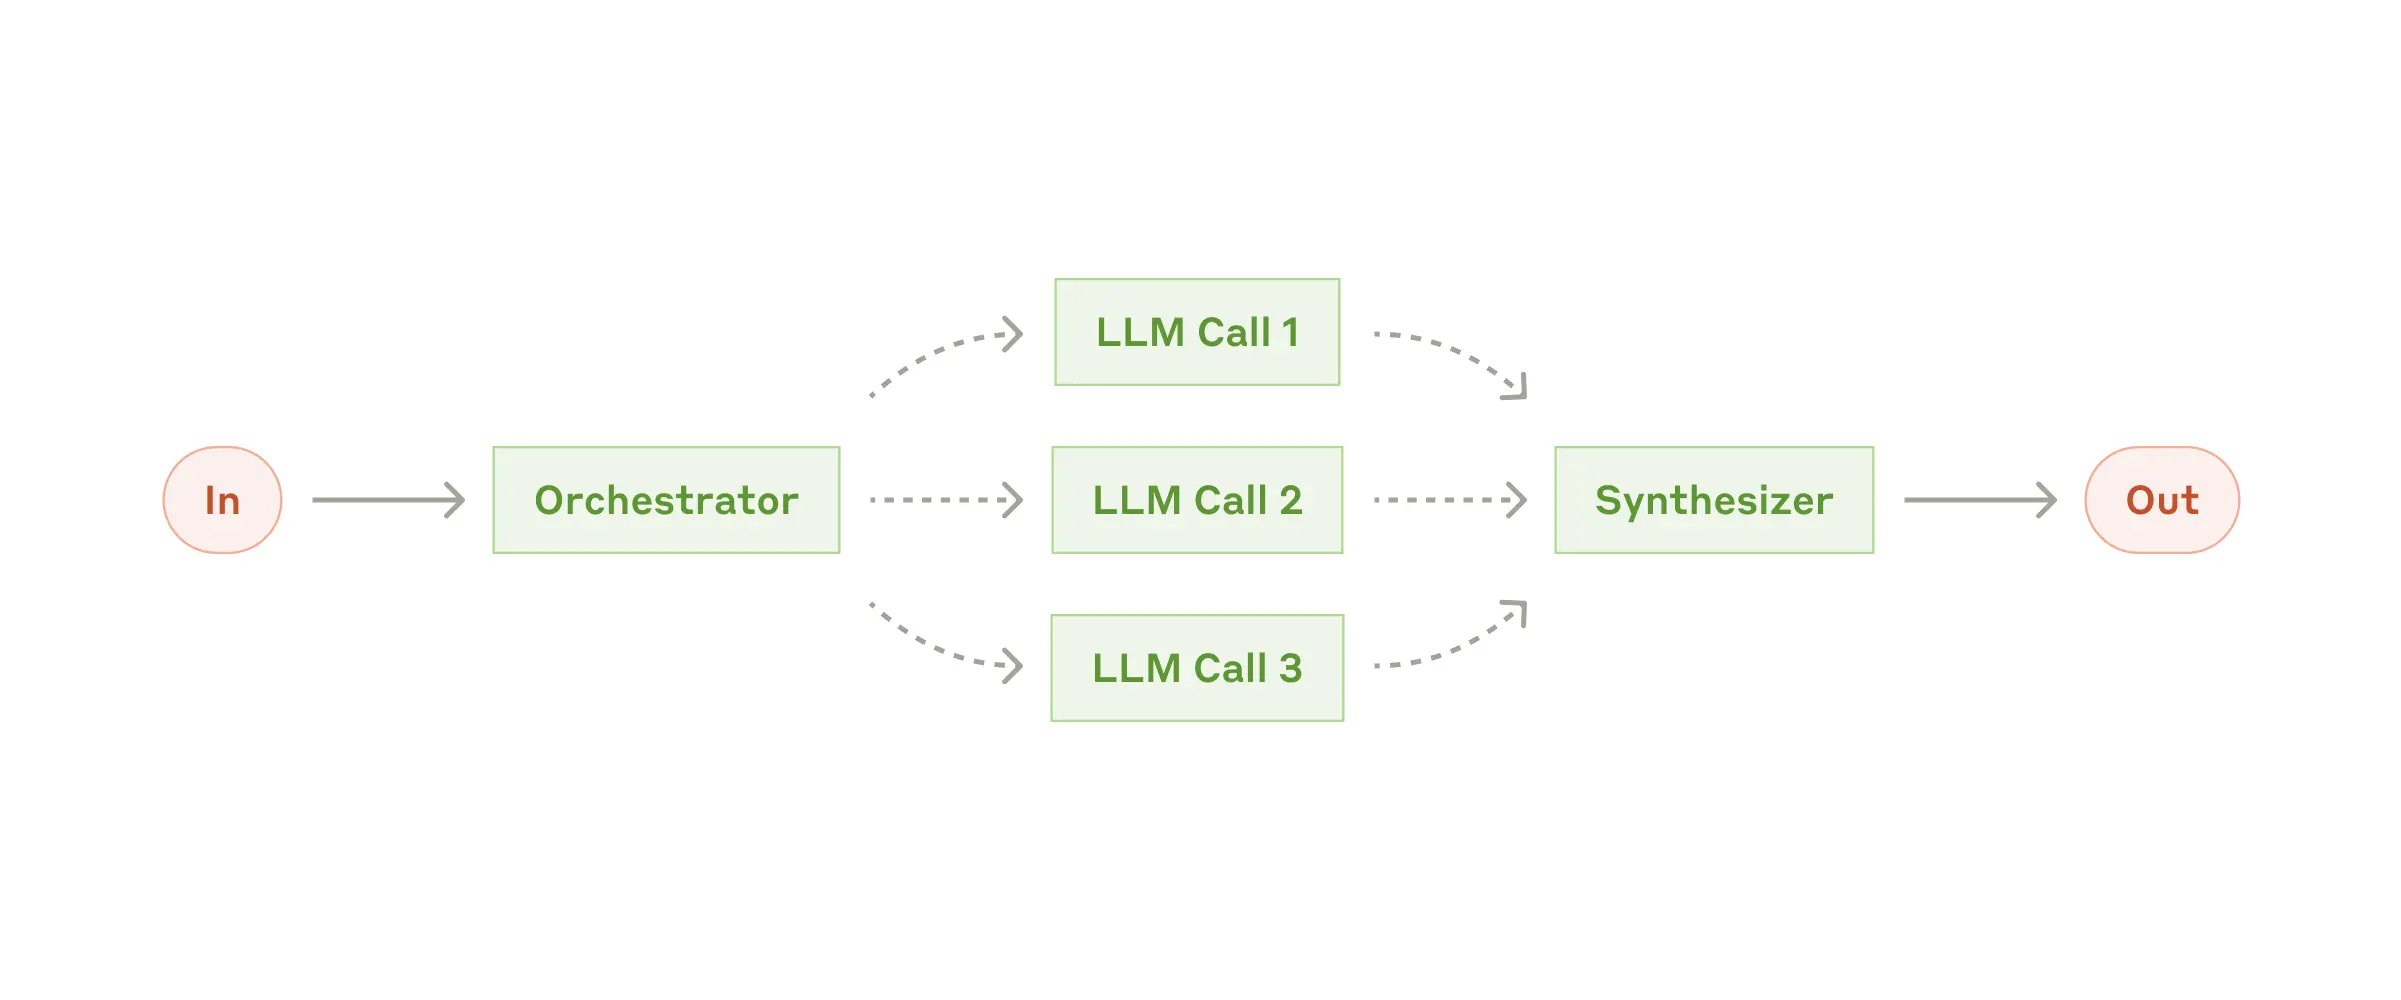
Complex Task
     ↓
Orchestrator LLM
     ↓
动态拆解 Subtasks
     ↓
 ┌──────┬──────┬──────┐
 ↓      ↓      ↓      ↓
W1     W2     W3     W4
 └──────┴──────┴──────┘
         ↓
      Synthesis
         ↓
    Final Result
与 Parallelization 的关键区别
Parallelization:
Task
 ↓
程序提前知道:
A / B / C 三个任务
 ↓
并行执行
Orchestrator-Workers:
Task
 ↓
Orchestrator 分析
 ↓
“这个任务需要 A、C、F、G”
 ↓
动态创建 Worker Tasks
也就是说:
Parallelization
≈ Static DAG
Orchestrator-Workers
≈ Dynamic DAG GenerationCoding 示例
用户:
修复这个 GitHub Issue系统一开始并不知道:
要改几个文件?
哪些文件?
每个文件改什么?
是否需要补测试?
是否需要改配置?
这些 Subtasks 必须在运行过程中动态确定。
十、Workflow:Evaluator-Optimizer
在 Evaluator-Optimizer Workflow 中:
一个 LLM 负责生成;
另一个 LLM 负责评估和反馈;
然后循环改进。
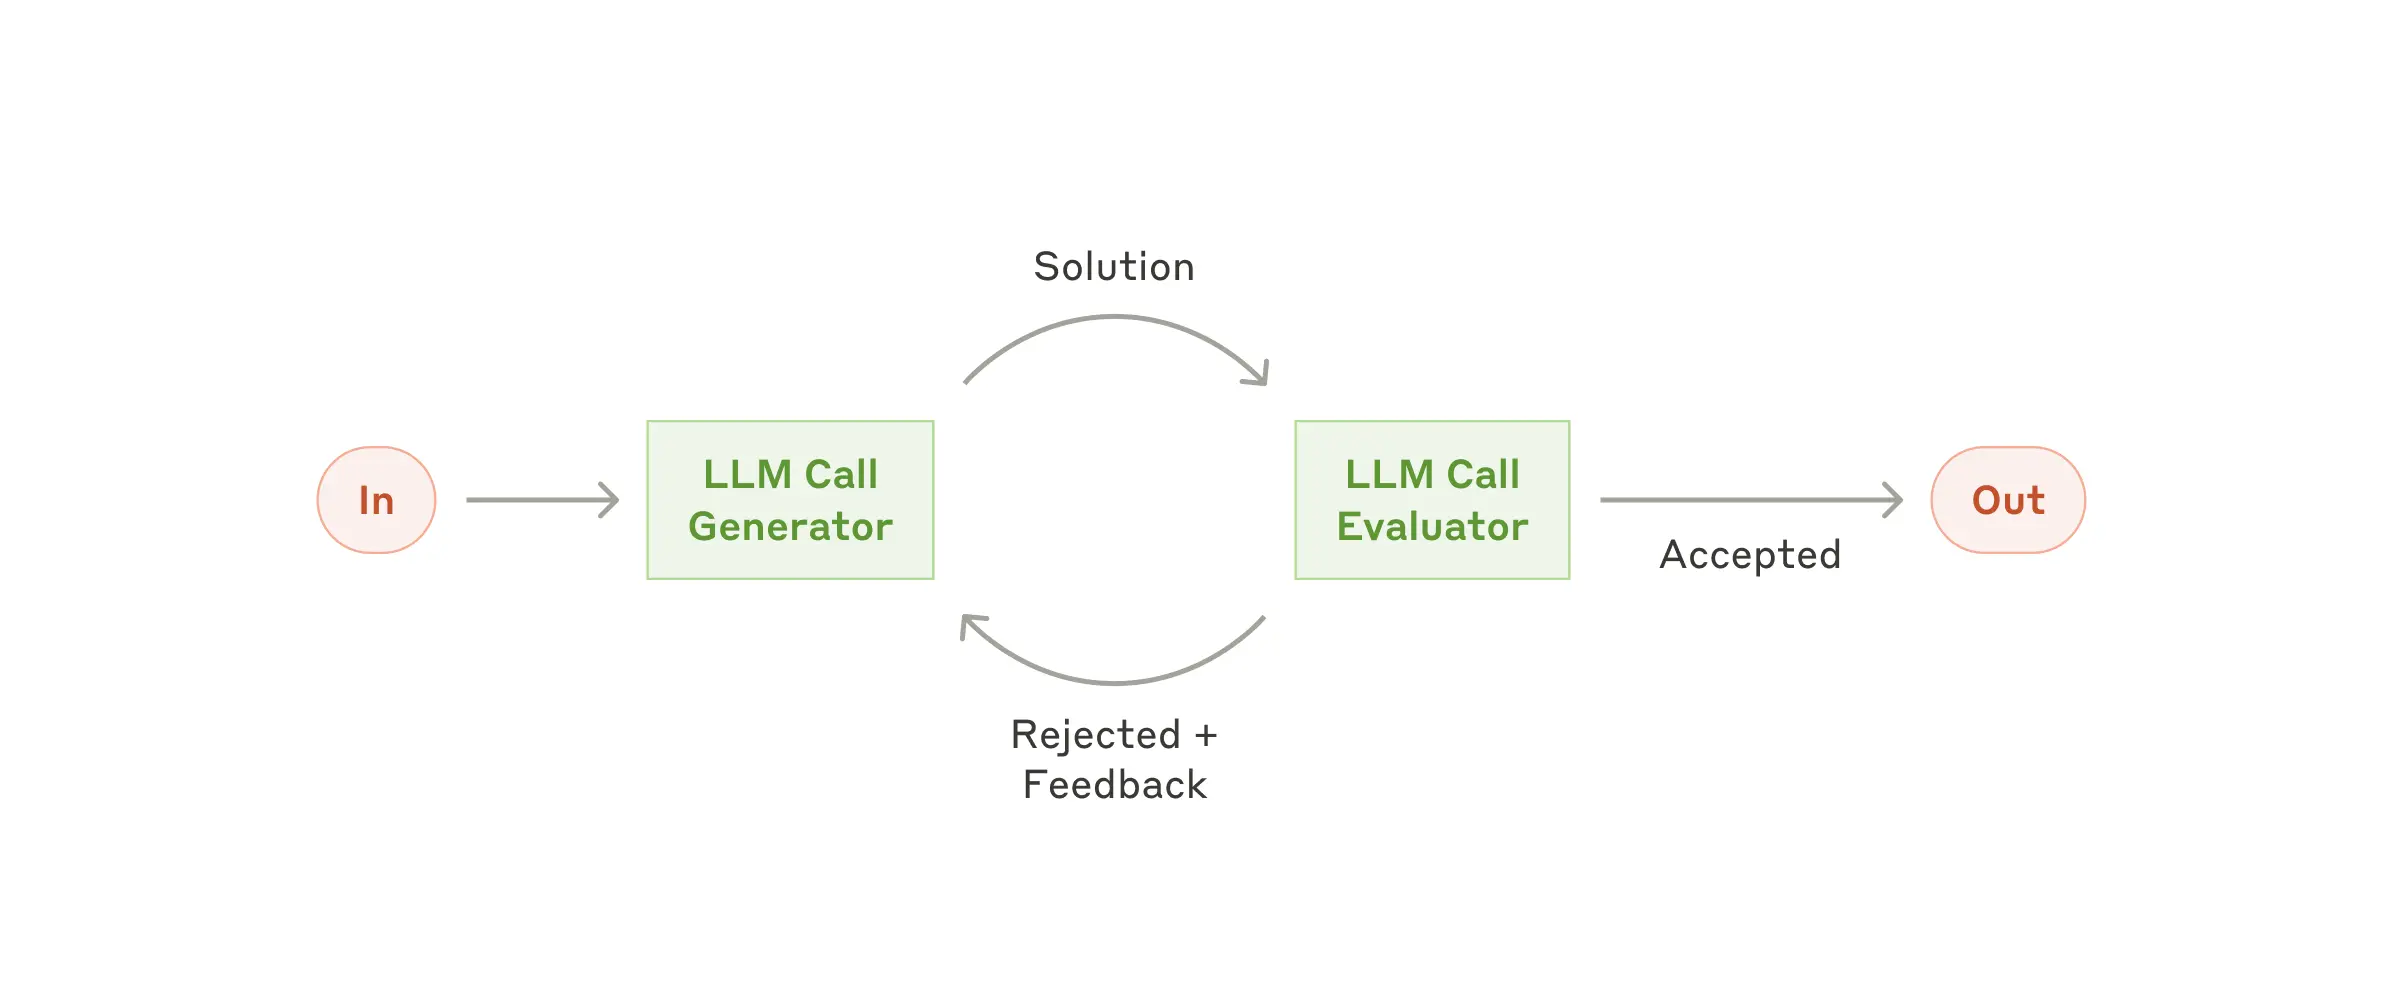
Generator
   ↓
 Draft
   ↓
Evaluator
   ↓
Feedback
   ↓
Generator
   ↓
Revision
   ↓
Evaluator
   ↓
...
最终需要明确的停止条件:
Evaluator
   ↓
达到标准?
 /      \
是       否
↓        ↓
Stop   Revision
什么时候适合?
必须至少满足两个条件。
条件一:存在明确 Evaluation Criteria
也就是说:
“更好”能够被定义条件二:Feedback 能真正产生改进
Draft
 ↓
具体 Feedback
 ↓
Revision
 ↓
指标明显提升
而不是:
Draft
 ↓
“可以更好”
 ↓
换一种说法
 ↓
继续换一种说法
译者注:
Evaluator-Optimizer 最关键的问题是:
什么时候停止?
需要提前设计:
Quality Threshold
Maximum Iterations
No Improvement Detection
Token Budget
Time Budget
十一、Agents
随着 LLM 在以下能力上不断成熟:
- 理解复杂输入
- Reasoning
- Planning
- Reliable Tool Use
- Error Recovery
Agent 开始逐渐进入生产环境。
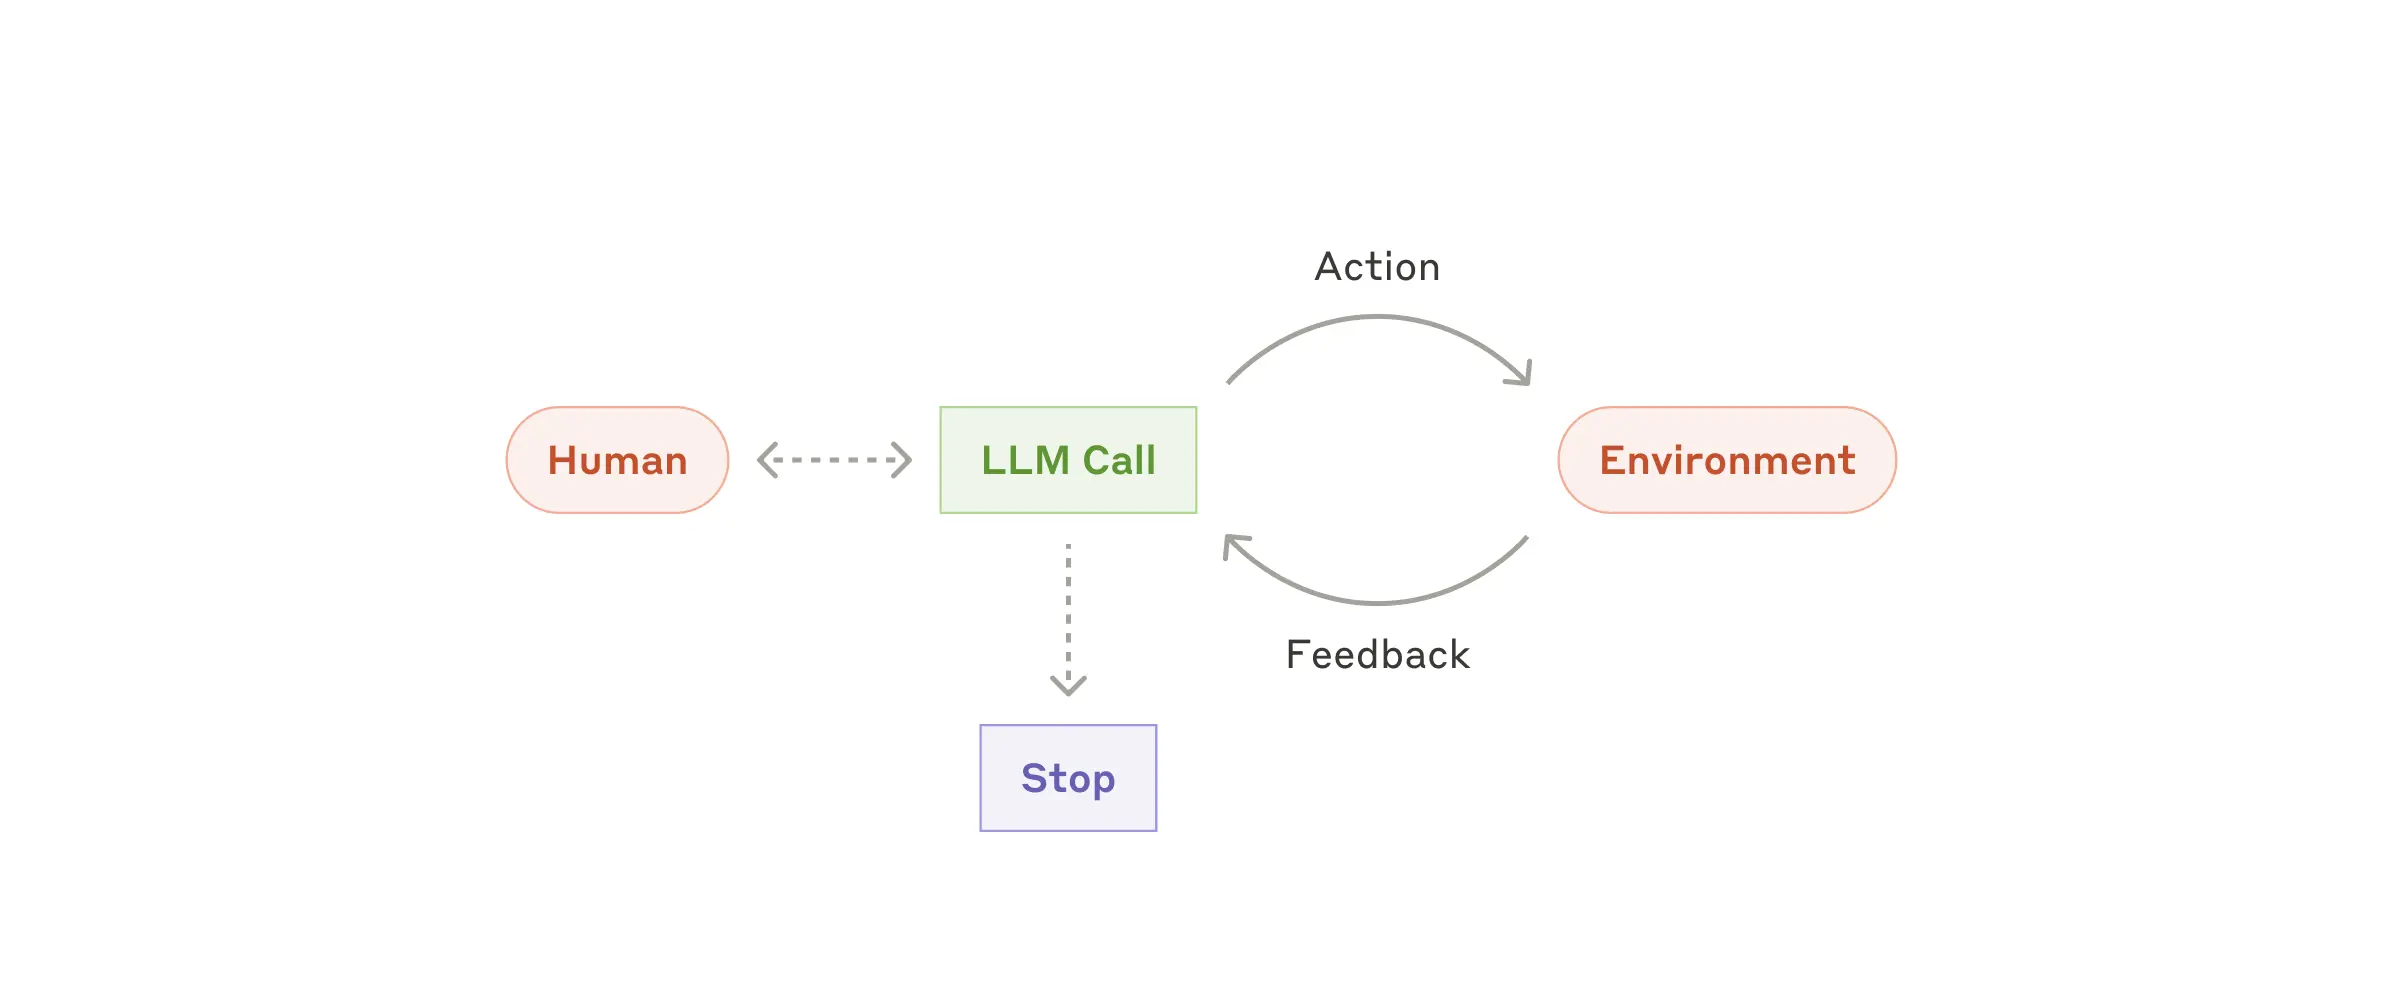
Agent 最基本的执行机制可以表示为:
Human Request
     ↓
Understand Task
     ↓
Plan / Decide
     ↓
Choose Action
     ↓
Call Tool
     ↓
Environment
     ↓
Observation
     ↓
Update Understanding
     ↓
Decide Next Action
     ↓
    ...
也就是:
Decide
  ↓
Act
  ↓
Observe
  ↓
Decide
  ↓
Act
  ↓
Observe
  ↓
...
Ground Truth
Agent 在执行过程中非常重要的一件事情是:
不断从 Environment 获得 Ground Truth。
例如:
Tool Call Result
Code Execution Result
Database Result
API Response
Test Result
File State
Browser State
于是 Agent 不应该只是:
LLM 思考
   ↓
LLM 再思考
   ↓
LLM 认为完成了
而应该是:
LLM 判断
   ↓
真实 Action
   ↓
Environment 返回真实结果
   ↓
LLM 根据真实结果继续判断
Agent 为什么需要 Stop Conditions?
因为 Agent 可能运行很多 Turn。
如果没有约束:
判断
 ↓
调用工具
 ↓
失败
 ↓
再调用
 ↓
换一个工具
 ↓
继续尝试
 ↓
...
可能无限运行。
因此通常需要:
Max Iterations
Max Tool Calls
Max Model Calls
Deadline
Token Budget
Cost Budget
No-progress Detection
Human Checkpoint
译者注:
Agent 最小实现虽然简单,但生产级 Agent 真正困难的是外围 Runtime。
              ┌── Permissions
              ├── Tool Schema
              ├── Context
              ├── Budget
LLM Loop ─────┼── Timeout
              ├── Retry
              ├── Guardrails
              ├── Stop Conditions
              └── Eval
十二、组合和定制这些 Pattern
这些 Building Blocks 并不是规定式架构。
它们只是生产环境中经常出现的 Pattern。
实际系统完全可能是:
Input
 ↓
Routing
 ↓
Parallel Evidence Collection
 ↓
Prompt Chaining
 ↓
证据够吗?
 /      \
是       否
↓        ↓
Report   Agent Investigation
           ↓
        More Tools
           ↓
        New Evidence
           ↓
        Evaluator
           ↓
        Final Report
因此重点不是:
“我要选哪一个 Pattern?”而是:
这个问题的哪一部分
适合什么控制方式?
最终原则仍然是:
增加复杂度
    ↓
必须能够证明
    ↓
Outcome 改善
十三、总结
在 LLM 领域取得成功,并不是构建最复杂、最先进的系统。
真正重要的是:
构建最适合自己需求的系统。
可以将 Anthropic 的整体思想浓缩为:
Start Simple
    ↓
Measure
    ↓
Identify Failure Cases
    ↓
Add Only Necessary Complexity
    ↓
Measure Again
在实现 Agent 时,有三个核心原则。
1. Simplicity
能用简单方案解决
        ↓
不要引入复杂 Agent
2. Transparency
Agent 做了什么?
为什么调用这个 Tool?
得到了什么 Observation?
为什么继续?
为什么停止?
这些过程应该尽可能可观察。
3. ACI
认真设计:
Agent-Computer Interface
包括:
Tool Name
Tool Description
Parameters
Return Schema
Error Semantics
Permissions
Examples
Edge Cases
附录 1:Agents in Practice
Anthropic 与客户合作的过程中发现,有两个领域特别适合 AI Agent。
它们共同具有:
Conversation
+
Action
+
Clear Success Criteria
+
Feedback Loop
+
Human Oversight
A. Customer Support
Customer Support 天然符合 Agent 模型。
用户提出问题
    ↓
Agent 理解需求
    ↓
查询 Customer Data
    ↓
查询 Order History
    ↓
查询 Knowledge Base
    ↓
决定 Action
    ↓
Refund / Update Ticket / Reply
    ↓
确认问题是否解决
它的重要优势是:
Success 可以比较明确地衡量。
B. Coding Agents
Coding Agent 也是一个非常典型的 Agent 场景。
Issue
 ↓
理解代码
 ↓
定位文件
 ↓
修改代码
 ↓
运行 Tests
 ↓
失败?
 /   \
是    否
↓     ↓
继续改  Human Review
Coding Agent 特别适合 Agent Loop,是因为它天然存在大量 Ground Truth:
Compiler
Tests
Linter
Runtime
Git Diff
File System
这让 Agent 能够形成非常清晰的 Feedback Loop。
附录 2:Prompt Engineering Your Tools
无论构建哪种 Agentic System,Tools 都很可能是重要组成部分。
Tool 本质上是:
LLM
 ↓
Tool Interface
 ↓
External System / API
 ↓
Tool Result
 ↓
LLM
Anthropic 强调:
Tool Definition 和 Tool Specification 应该获得与整体 Prompt 同等程度的工程投入。
Tool Format 的选择
同一个动作可能存在多种表达方式。
例如修改文件:
方案 A:
生成 Diff

方案 B:
重写整个文件
对传统程序而言,两者可能可以无损转换。
但对 LLM 而言:
格式复杂度
≠
生成难度相同
例如 JSON 中写代码:
需要处理:
newline escaping
quote escaping
nested structure
Markdown 则更加自然。
因此 Tool Format 应该遵循:
自然
+
低格式负担
+
低出错概率
ACI:Agent-Computer Interface
可以把 Tool Design 类比成人类世界的 HCI。
Human
 ↓
HCI
 ↓
Computer
对应 Agent:
Agent
 ↓
ACI
 ↓
Computer / Environment
好的 ACI 应该让模型:
知道什么时候使用这个 Tool
知道什么时候不能使用
知道每个参数是什么意思
知道返回结果代表什么
知道失败后怎么办
Poka-yoke:防错设计
Anthropic 特别强调:
不要只告诉模型:
“请小心,不要犯错。”更好的方法是:
重新设计 Tool
    ↓
让错误本身更难发生
例如:
Before

edit_file(
    path="../src/a.py"
)
Agent 更容易因为当前目录变化而出错。
改成:
After

edit_file(
    absolute_path="/repo/src/a.py"
)
从接口层面消除一类错误。
这就是:
Poka-yoke / Mistake-proofing。
最终学习框架
整篇文章最终可以压缩成下面这套判断逻辑:
真实问题
   ↓
Single LLM Call 能解决吗?
   ├─ Yes → 使用最简单方案
   │
   └─ No
       ↓
固定路径能提前定义吗?
       ├─ Yes
       │    ↓
       │  Workflow
       │    ├─ Prompt Chaining
       │    ├─ Routing
       │    ├─ Parallelization
       │    ├─ Orchestrator-Workers
       │    └─ Evaluator-Optimizer
       │
       └─ No
            ↓
执行路径是否依赖运行时 Observation?
            ├─ No → 继续优化 Workflow
            │
            └─ Yes
                 ↓
               Agent
                 ↓
       Decide → Act → Observe
            ↑            ↓
            └────────────┘
而无论使用哪一种架构,外围始终需要:
Tool Design
Context
Permissions
Budget
Timeout
Guardrails
Error Recovery
Stopping Conditions
Eval
Human Oversight
最终原则不是:
Build the most advanced Agent而是:
Build the simplest system
that reliably solves the problem.
即:
构建能够可靠解决问题的最简单系统。
易浅小站
EACHEN STUDIO / ARTICLE END